做产品、写内容、搭平台——把想法变成清晰好用的体验。
深度文章、分类浏览与全文检索,记录观察与实践。
多级目录、结构化文档与沉浸式阅读体验。
精选产品与创作实践,技术栈与成果一览。
博客与知识库联动,持续输出高质量内容。
写作、翻译、总结与问答能力,即将上线。
Latest Articles
观察、思考与实践的记录。
深入探讨了当前主流的对齐算法 RLHF(人类反馈强化学习) 与更高效的 DPO(直接偏好优化),并介绍了 LoRA 等参数高效微调技术(PEFT),展示了如何以更低的资源成本实现模型定制。
基于 MySQL 递归语法(WITH RECURSIVE)实现无限级商品分类查询方案,一键获取全部分层级数据,代码精简高效,可直接用于树形结构业务场景。
本文档为OpenClaw项目部署操作手册,适配Linux、macOS、Windows、Docker多环境,提供源码、npm、容器三种部署方案,适配服务器生产与本地调试场景。
Knowledge Base
系统化知识沉淀,随时查阅。
Reading
Portfolio
精选产品与创作实践。
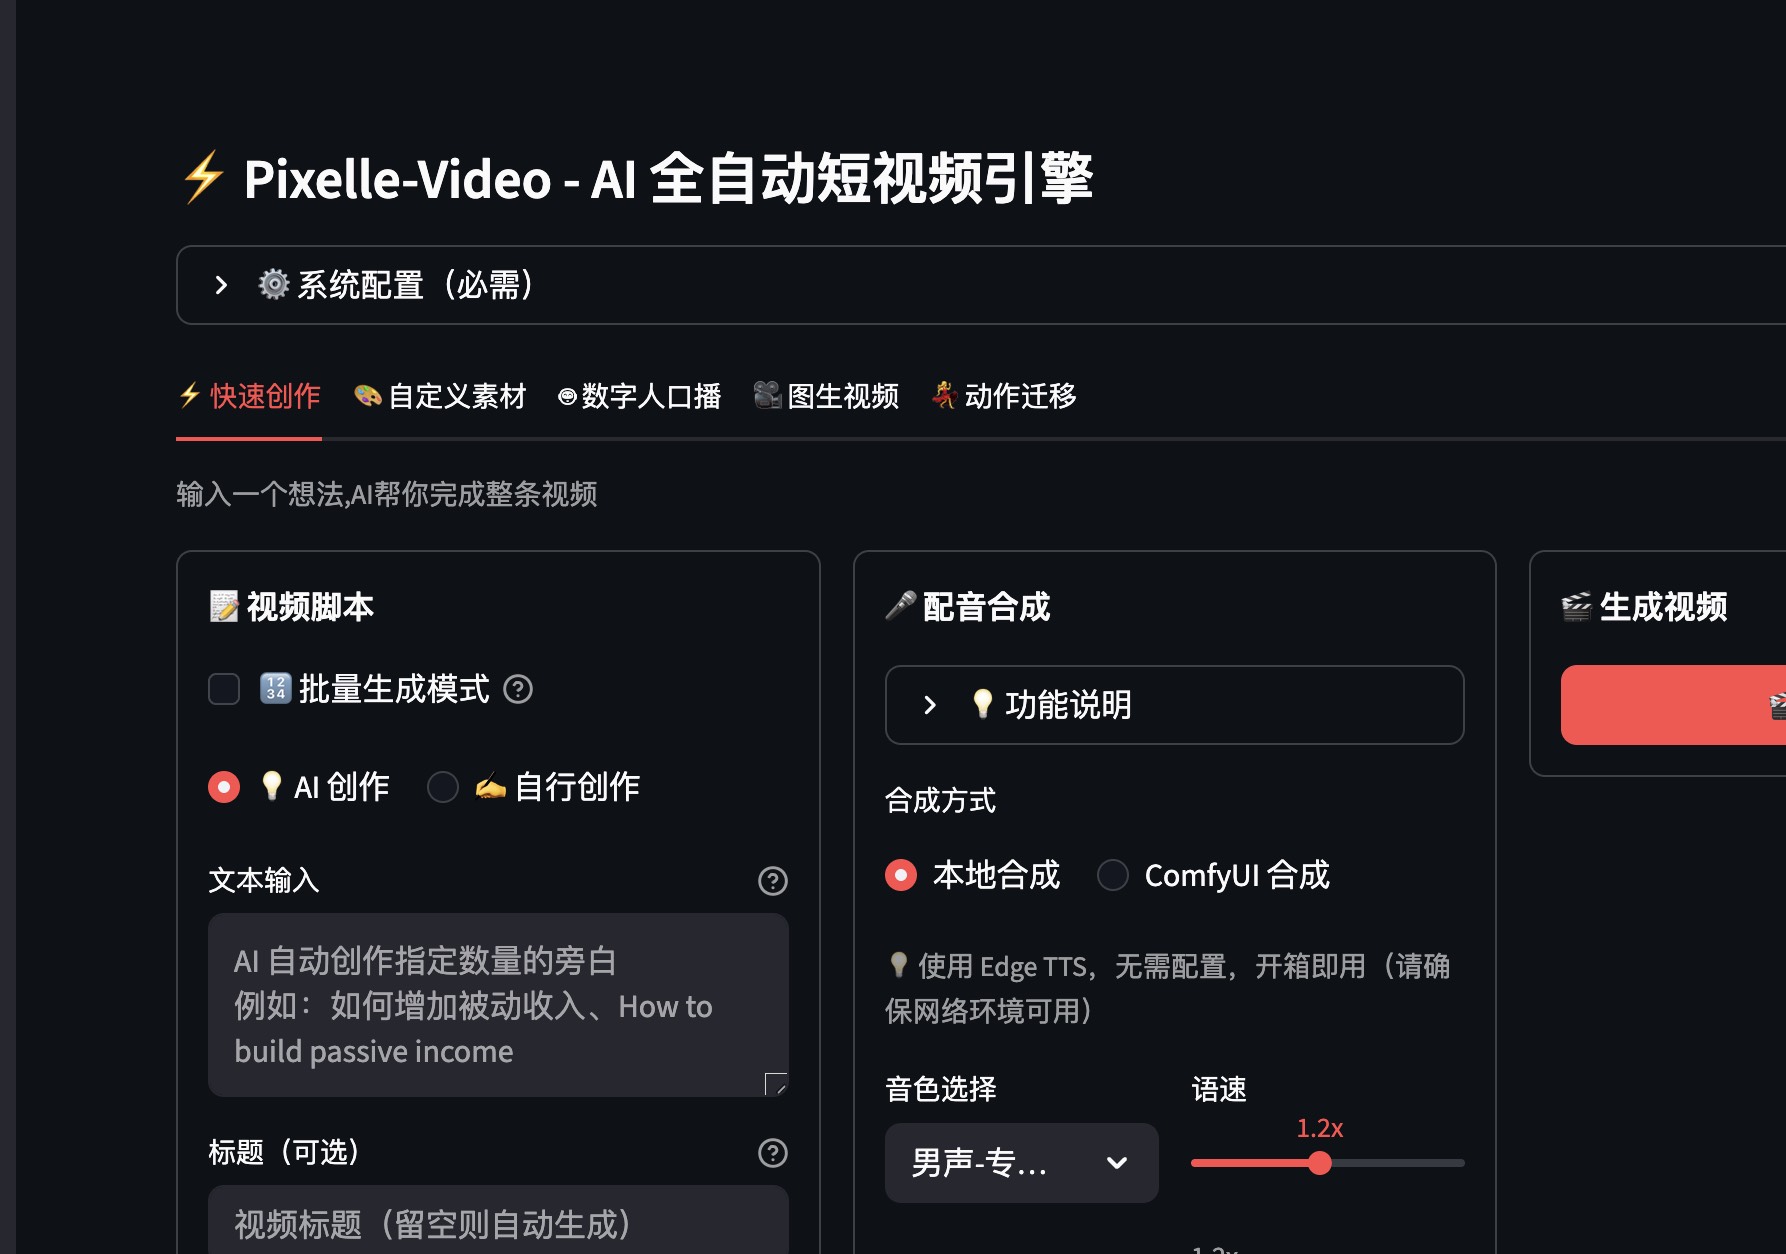
由 AIDC-AI 团队开发,基于多智能体协作框架(Multi-Agent),用户仅需输入一个主题关键词,系统即可一键完成文案创作、语音合成、背景音乐匹配及画面渲染,实现零门槛、工业级的视频自动化生产
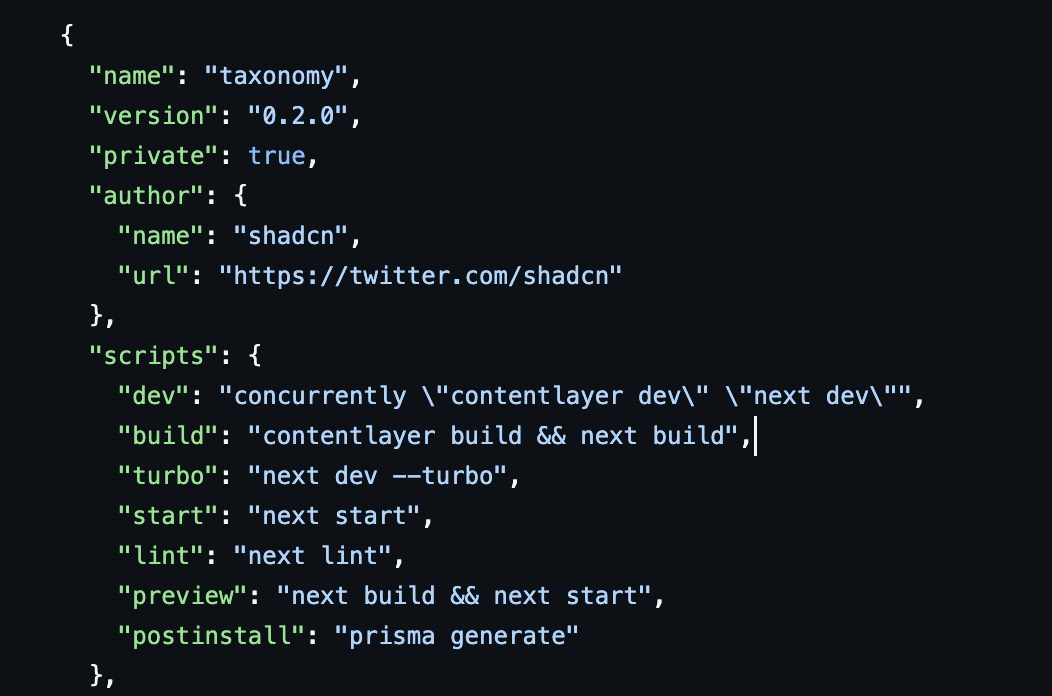
这是一个基于 Next.js 14 构建的高性能全栈开源项目 ,集成了 Server Components、NextAuth 身份验证和 Prisma 数据库管理。本项目深度实践了现代 Web 开发中的组件化设计与类型安全规范,是理解企业级 Next.js 应用的最佳范例。
Dify 是目前最先进的开源大语言模型应用开发平台 ,涵盖了从 RAG(检索增强生成)到 Agent 智能体的全流程编排。引用此项目旨在展示对 AI 基础设施的深度关注。未来本站的“AI 专区”也将参考其设计理念,构建智能化的内容生成与知识库问答流。
AI Zone